Was ist Paperless überhaupt?
Wer kennt es nicht – Dokumente, die man irgendwann mal als Brief, E-Mail oder WhatsApp erhalten hat zu suchen, ist der absolute Albtraum. Papierordner, Chats, digitale Ordner und Co. werden durchforstet aber man findet es einfach nicht – wo hab ich nochmal meine Rechnung abgelegt…?
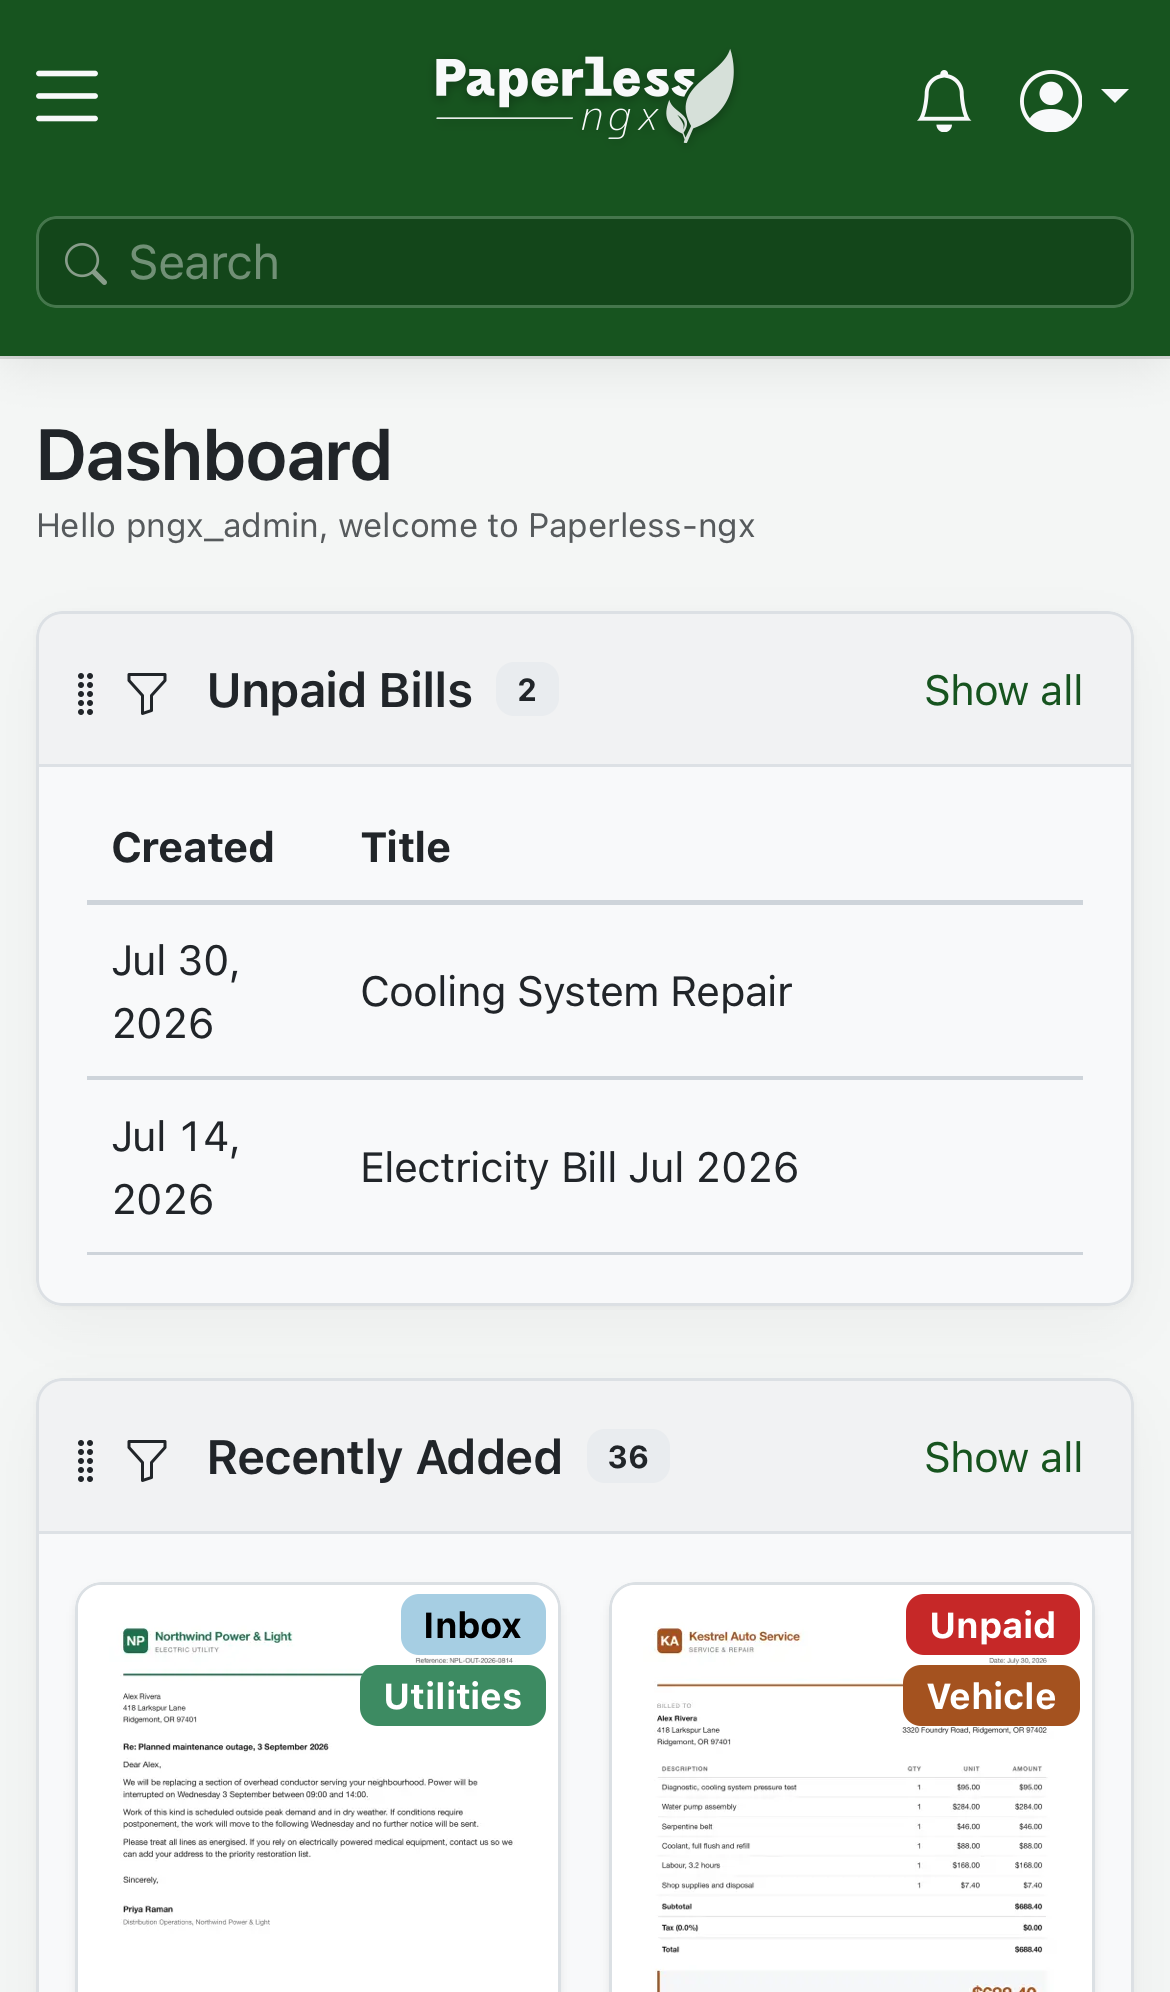
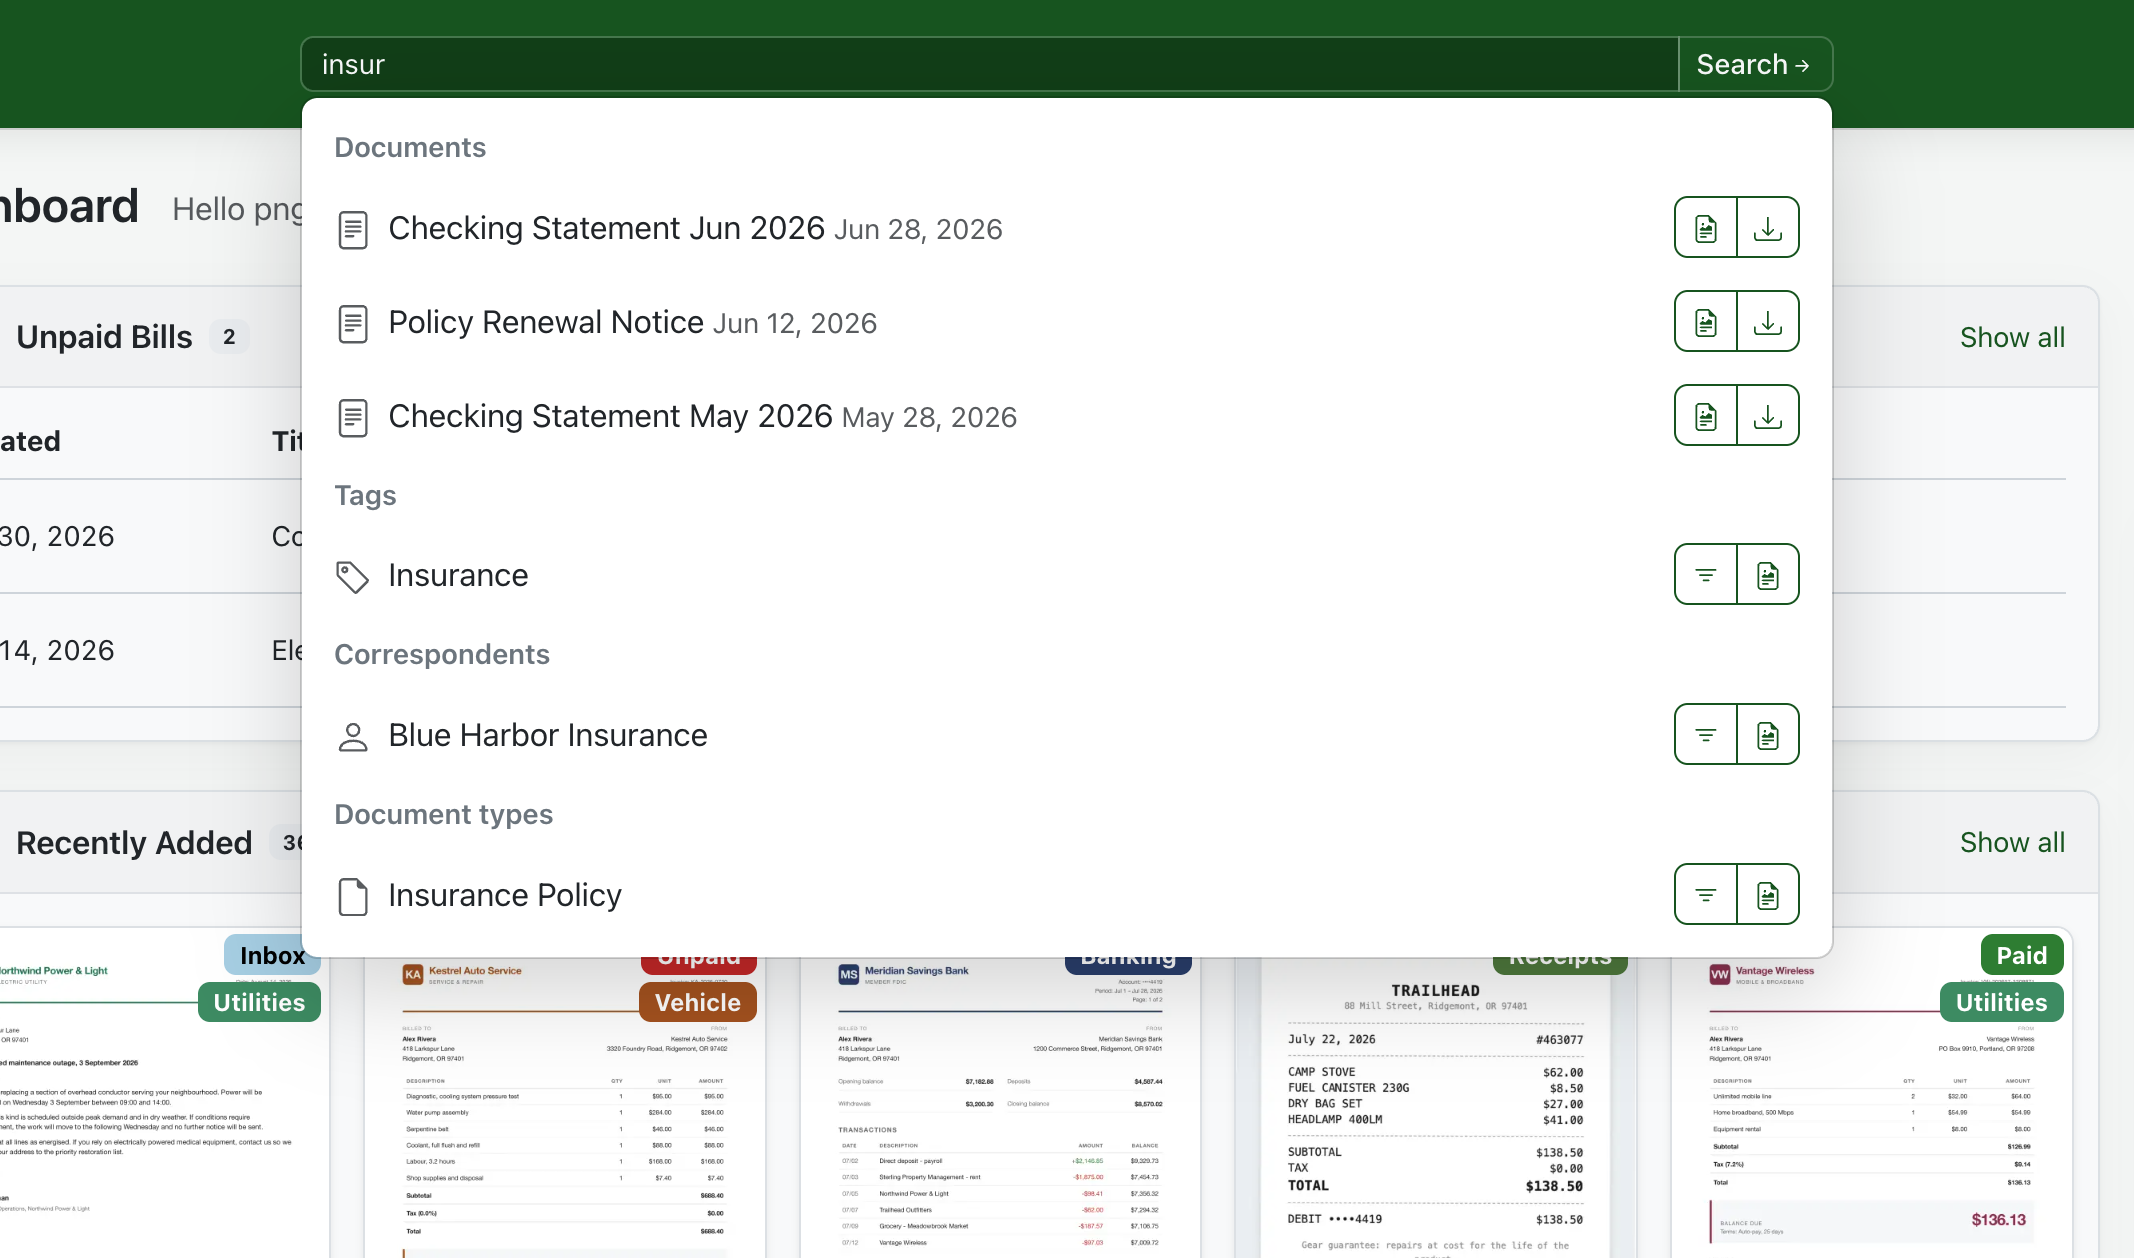
Genau hier ist ein Dokumentenmanagementsystem sinnvoll, denn damit lassen sich Dokumente digital einfach strukturieren und durchsuchen. Paperless-ngx ist vielleicht eines der bekanntesten Tools in der Open-Source Community und dadurch weit verbreitet. Mittels OCR-Funktion kannst du deine Dokumente durchsuchbar machen, Tags & Korrespondenten können Dokumente kategorisieren und das Tool kann unabhängig von allen Anbietern betrieben werden. Viele betreiben Paperless selbst als Docker-Anwendung oder Hosten sich einen SaaS-Service – ganz deine Entscheidung. Somit nerven dich keine pfiffigen Lizenzkosten oder Abhängigkeiten und du hast freie Hand.
Was Paperless eigentlich kann
Paperless installierst du via Docker-Container auf einem Host deiner Wahl – egal ob VPS, Synology NAS oder Raspberry Pi – eine Vorlage für deine YML-Datei findest du unten.
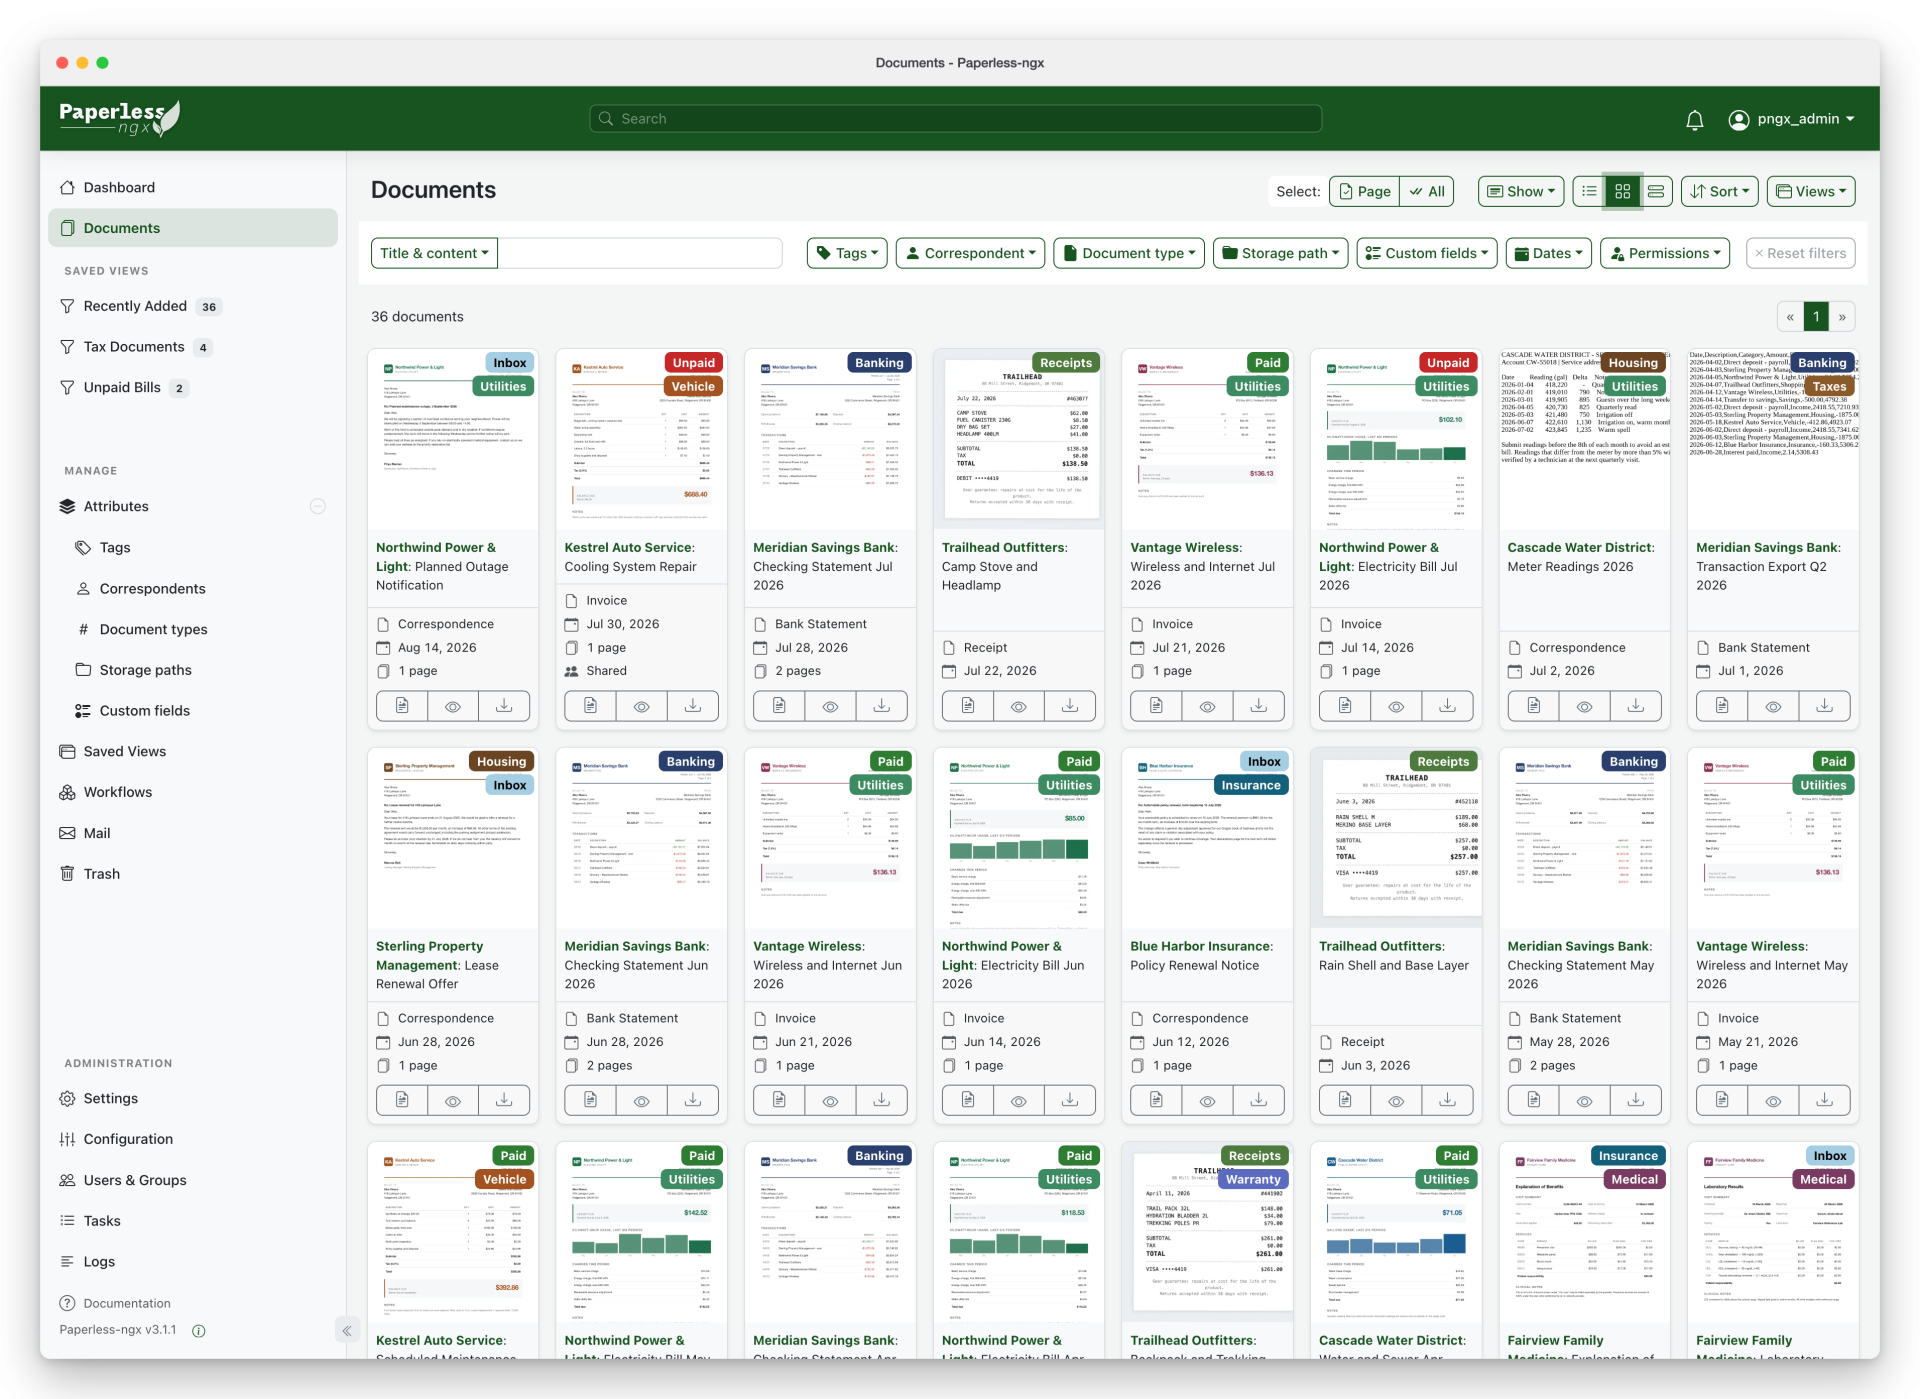
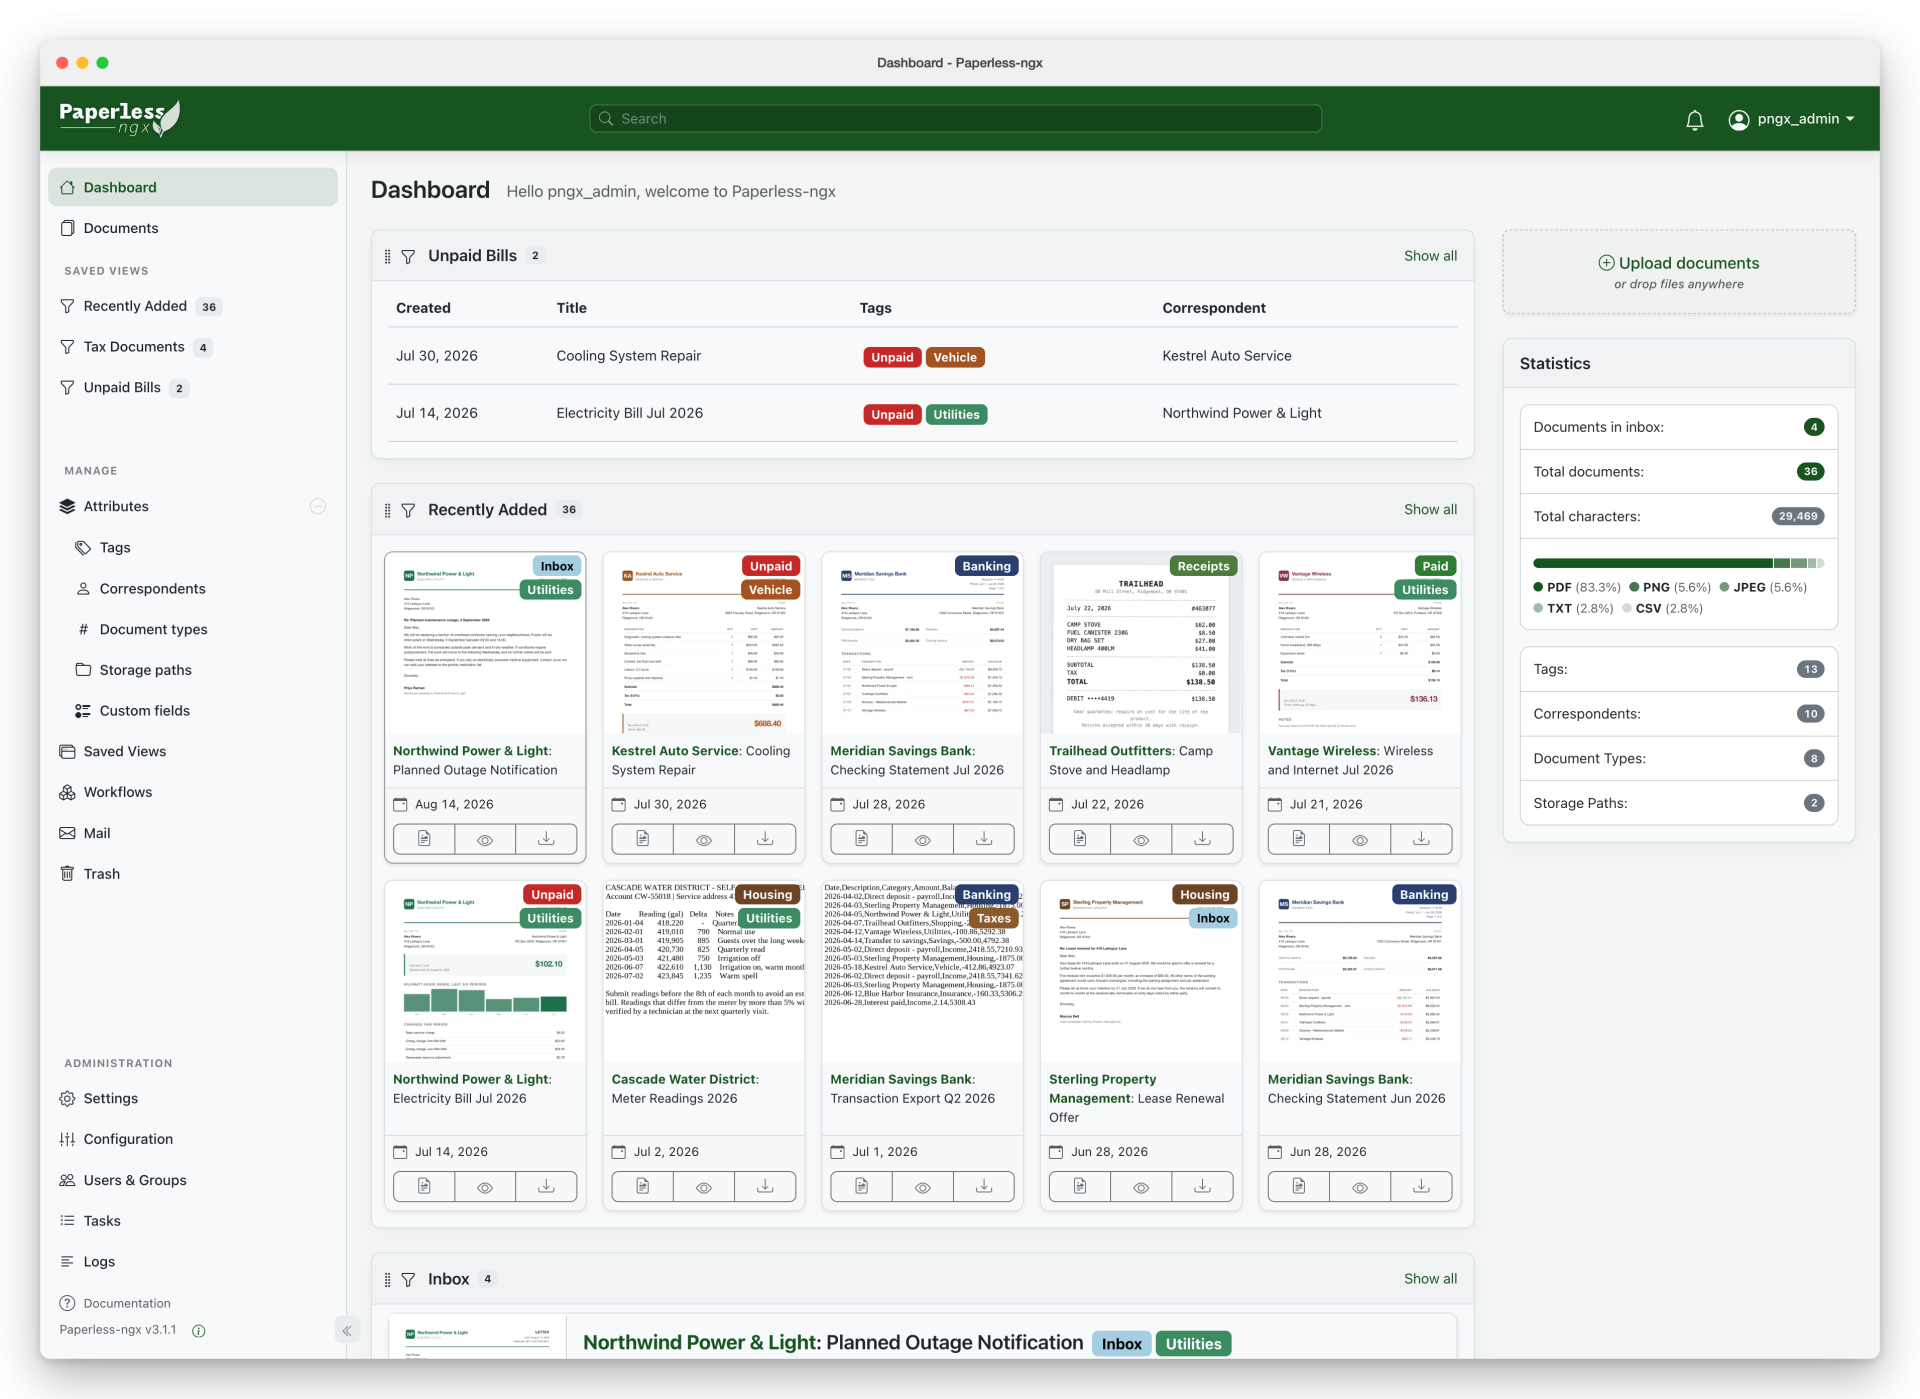
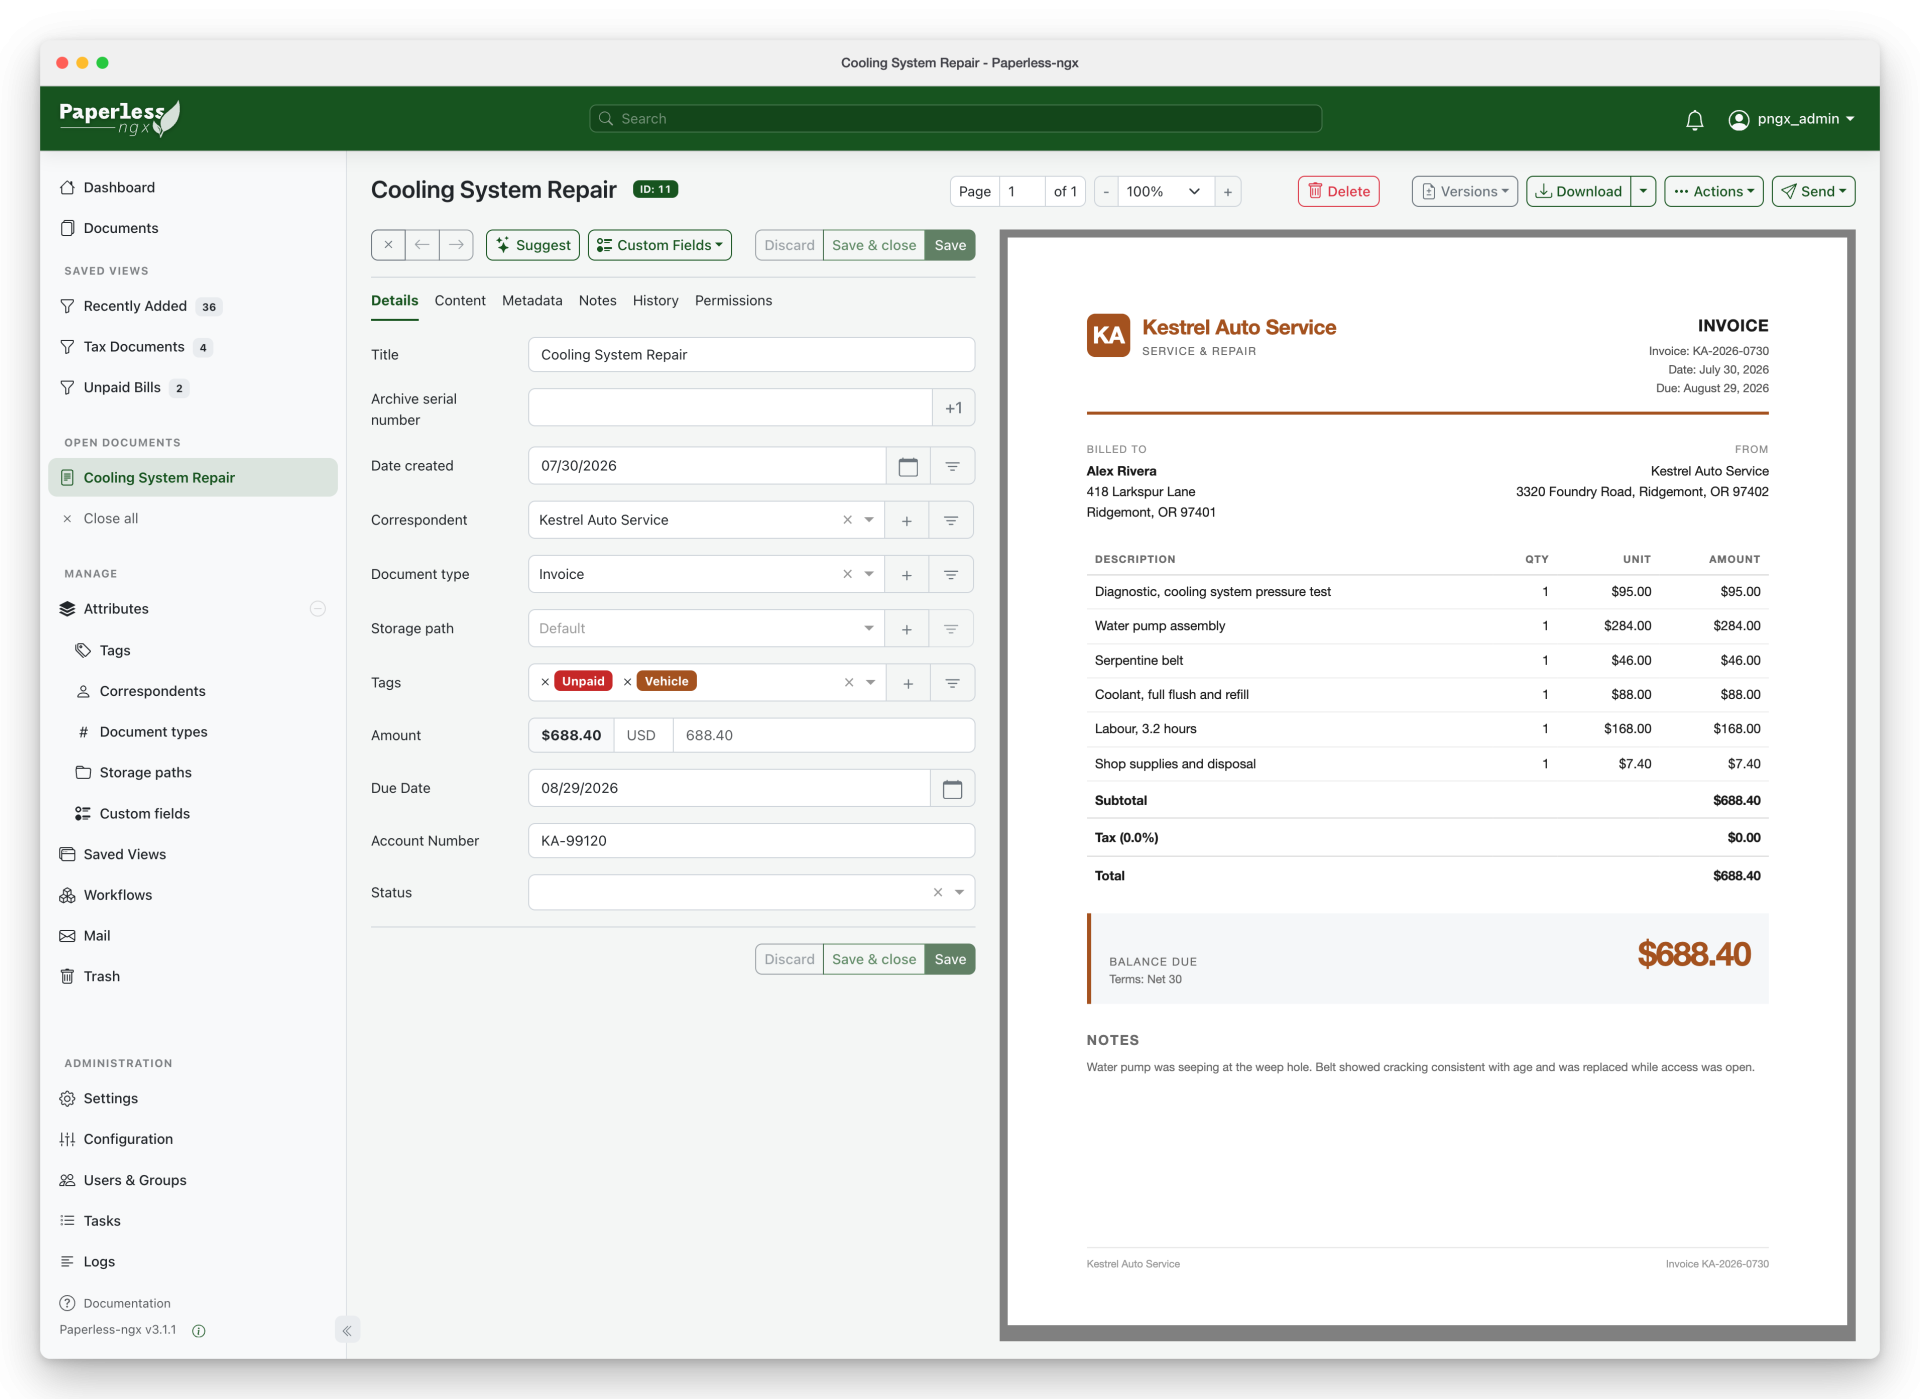
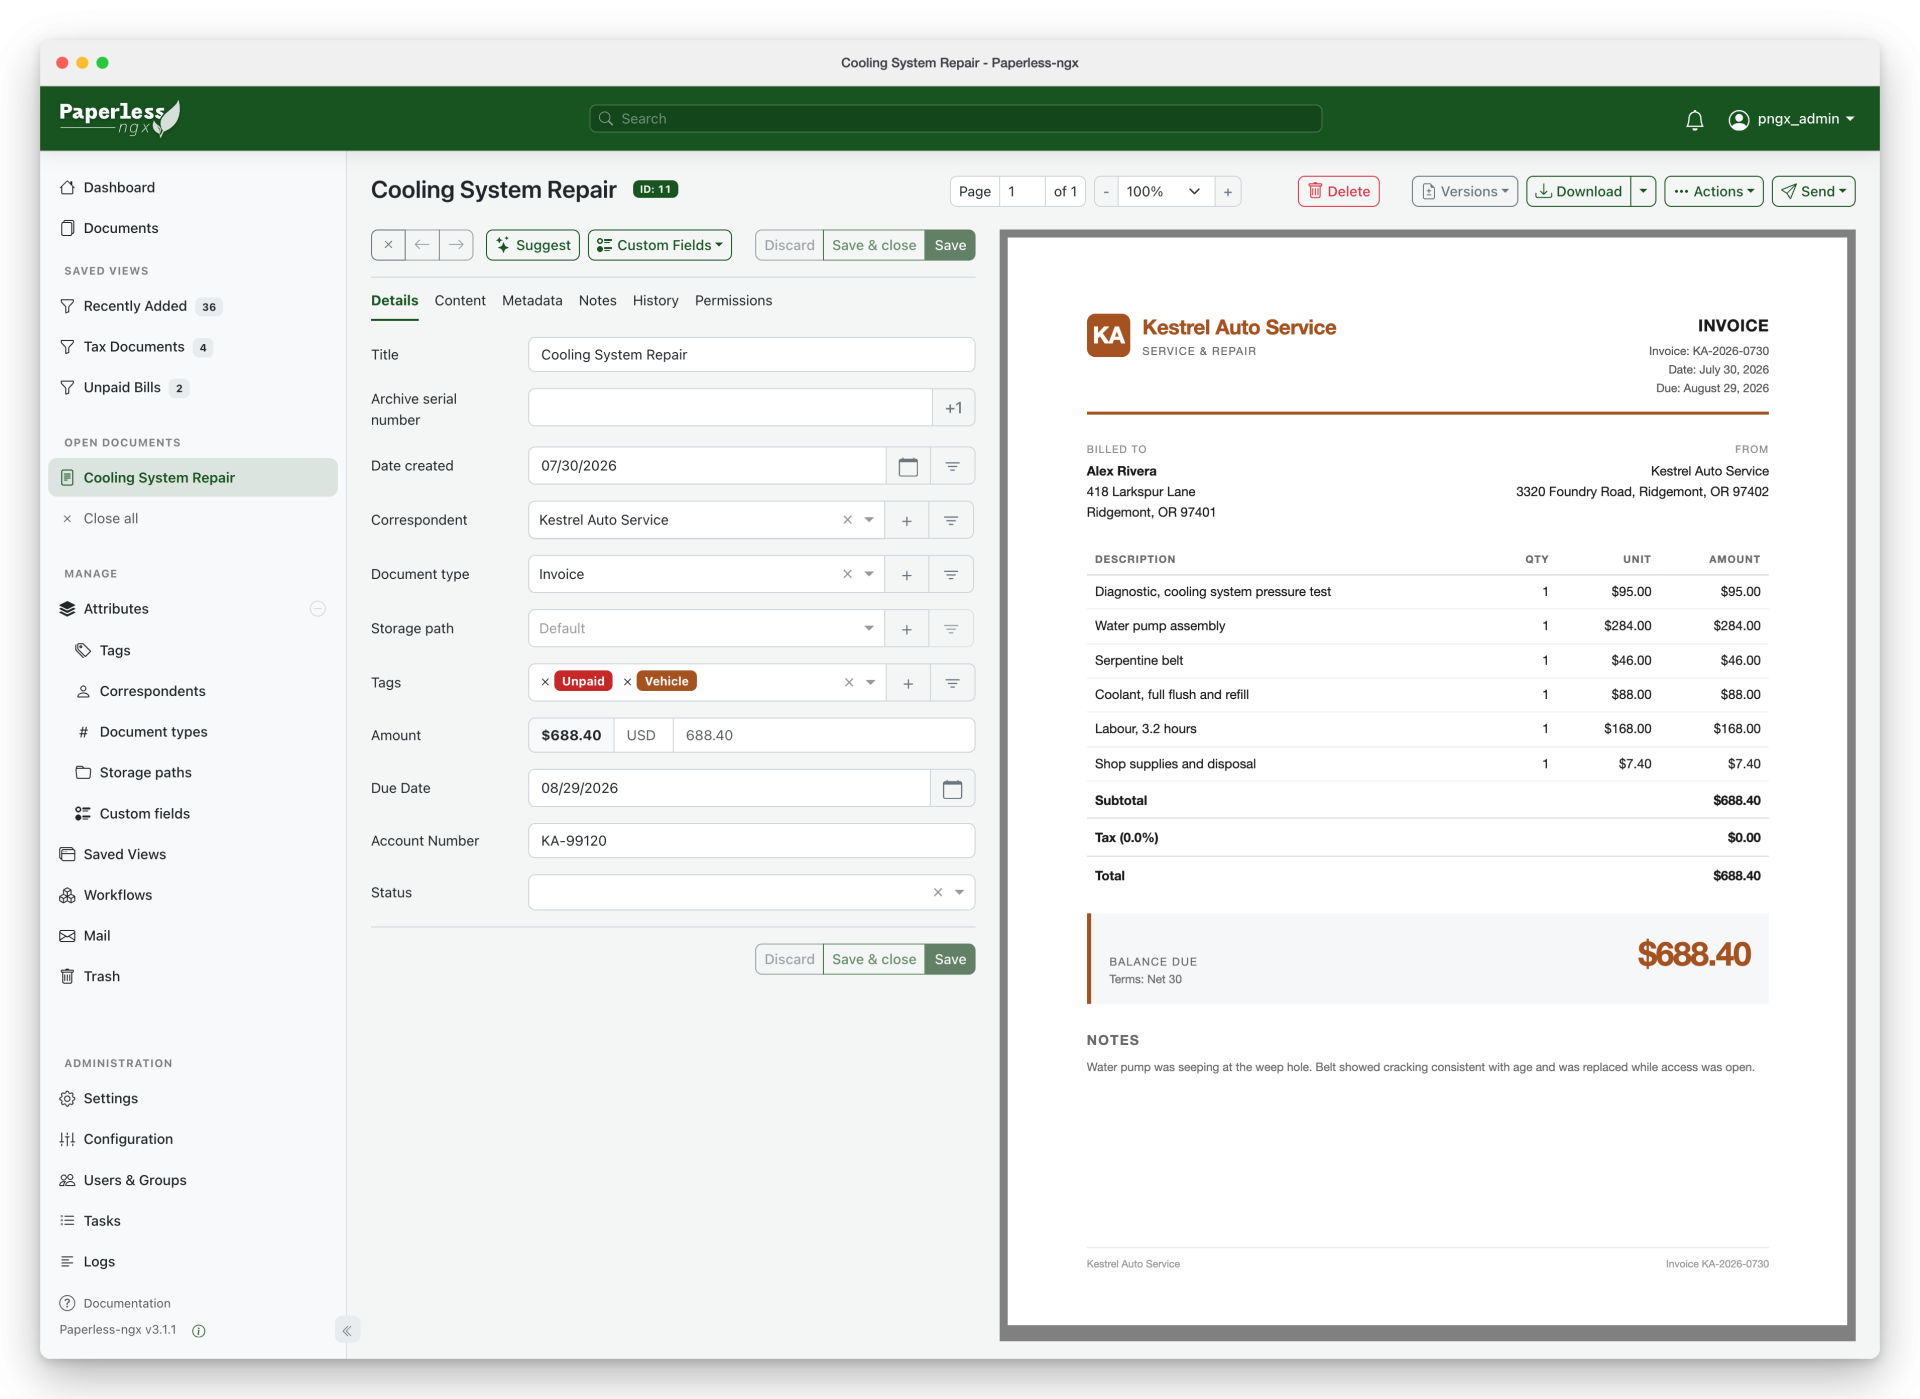
In der Grundinstallation hast du die Möglichkeit, PDF-Dokumente via Drag-and-drop, via FTP-Ordner oder auch via Mail zu konsumieren und so in Paperless hochzuladen. Ein bereits integrierter OCR-Scan durchsucht deine Dokumente und speichert nicht nur Titel & Co., sondern legt das Dokument so ab, dass du es später mittels OCR durchsuchen kannst.
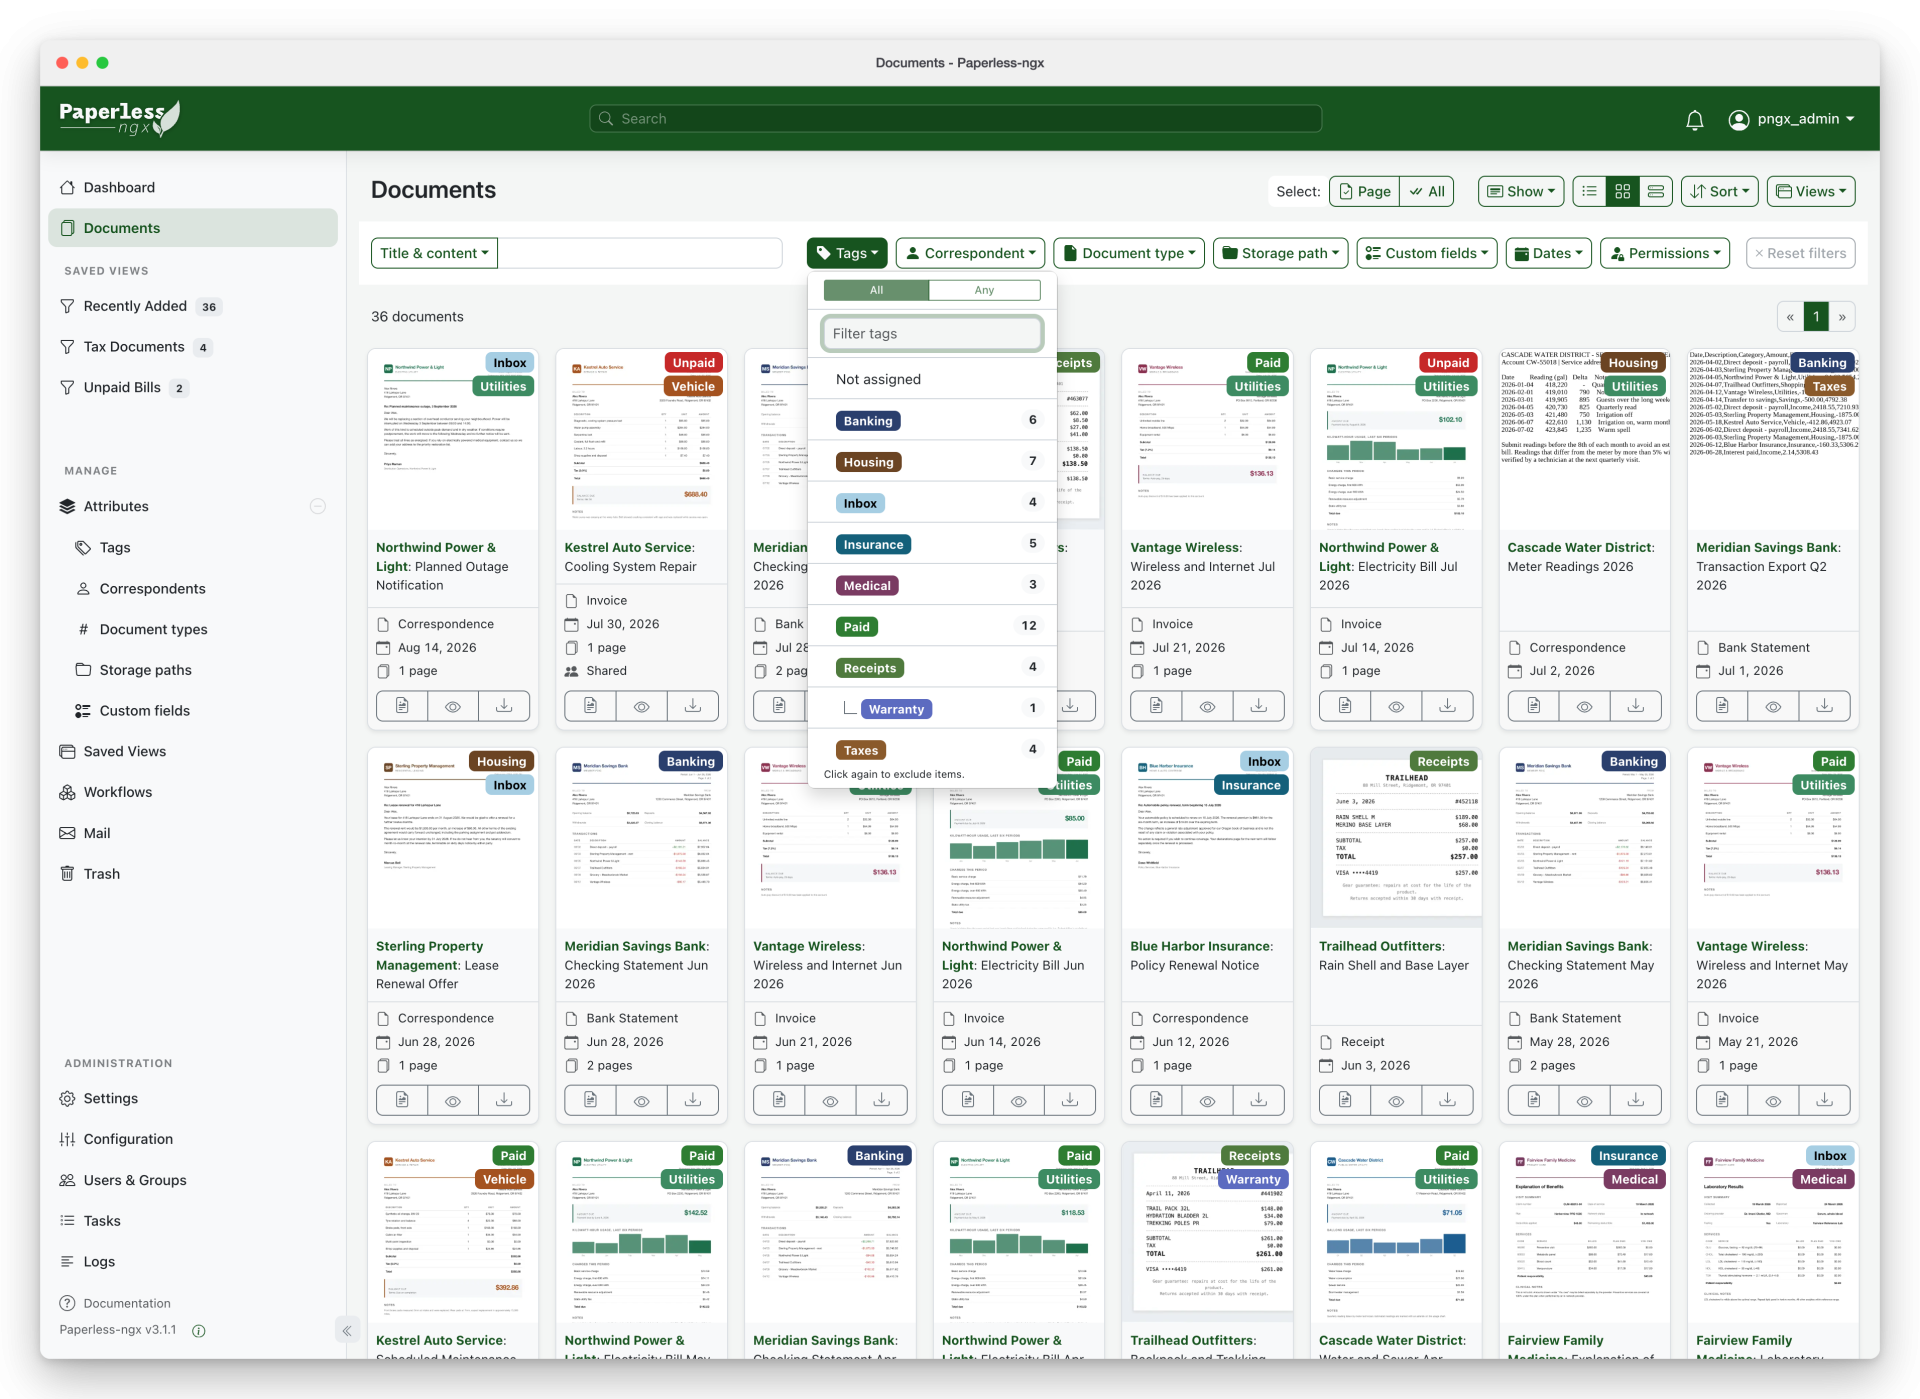
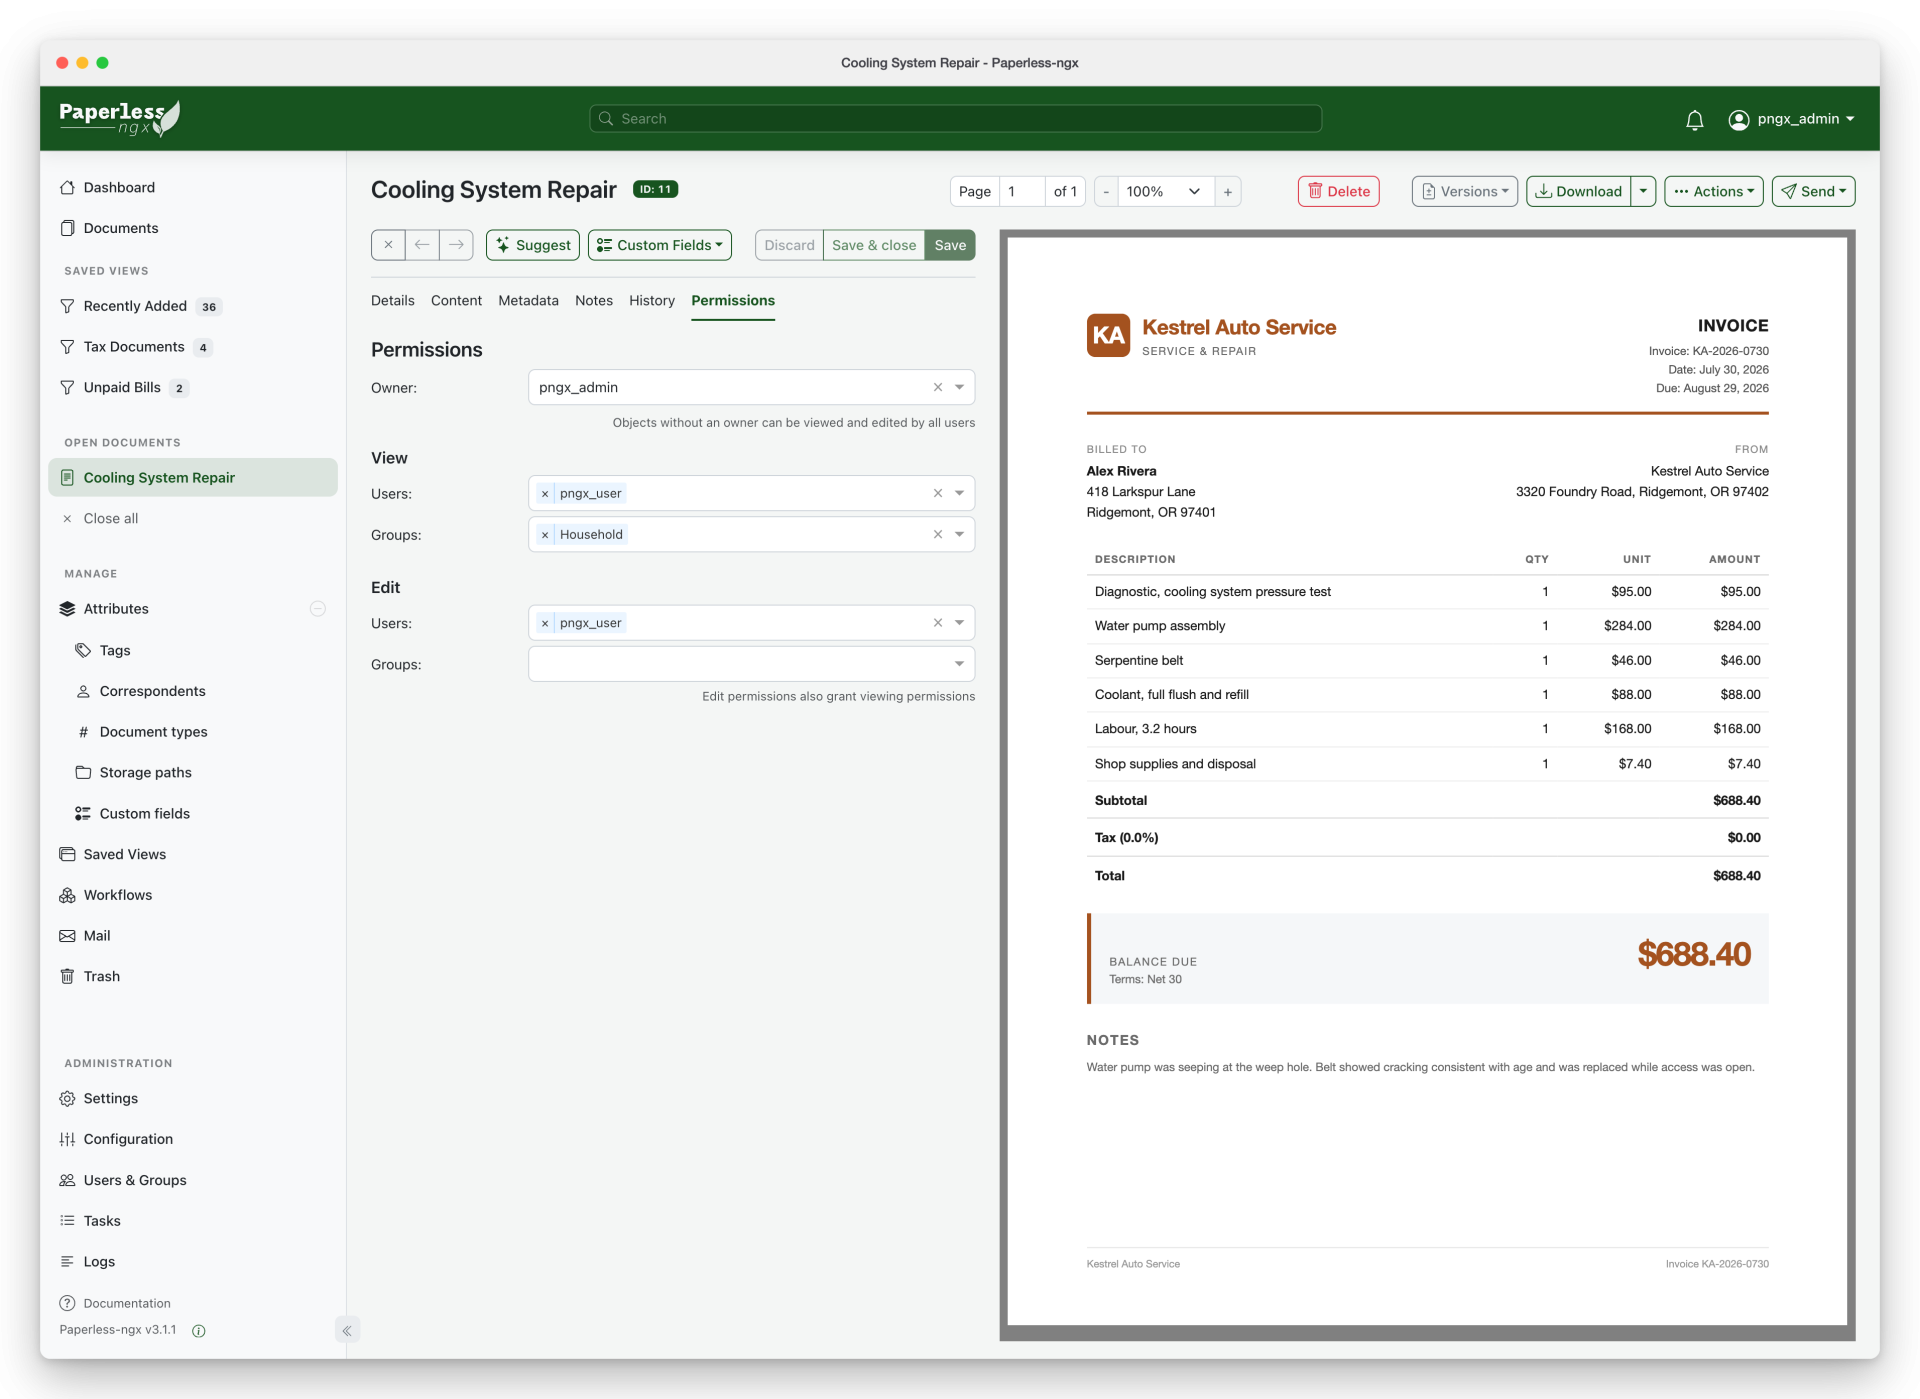
Daneben kannst du verschiedene Attribute an Dokumenten pflegen, die man später auch zum Filtern verwenden kann. Darunter fallen beispielsweise:
- Korrespondent: Bedeutet, wem das Dokument zuzuordnen ist. Beispielsweise gehört eine Rechnung von Amazon zum Korrespondenten Amazon.
- Dokumententyp: Handelt es sich beispielsweise um eine Rechnung, einen Vertrag oder etwas anderes?
- Tags: Weise verschiedene Kennzeichen zu, um Dokumente zu gruppieren, beispielsweise nach Kunde „XY“ oder „Studium“.
- weitere kundenspezifische Attribute sind nach Bedarf möglich – z. B. Rechnungsnummer
Mit der integrierten API kannst du noch mehr aus Paperless rausholen: eigene Workflows, Genehmigungsschritte oder weitere Verarbeitung in diversen Systemen wie dem Automatisierungstool „n8n“ ergänzen.. Hier sind dir also keine Grenzen gesetzt.
Für wen lohnt sich das?
Meiner Meinung nach ist Paperless für jedermann sinnvoll – egal ob Unternehmer oder Privatanwender. Mit den integrierten Funktionen wie „E-Mail-Import“ kannst du Dokumente, die in unterstützten Formaten wie PDF an dich geschickt werden automatisch konsumieren. Die Suche funktioniert tadellos und mit der aktiven Community erhält man stetig neue Features und Fixes – hier können Bugs & Anfragen auch veröffentlicht werden: https://docs.paperless-ngx.com. Zudem erhält man mit der API eine Möglichkeit Paperless auf ein neues Level zu bringen und so beispielsweise Rechnungsworkflows zu realisieren.
Mit Dokumentenscanner kannst du direkt Dokumente über FTP-Ordner in Paperless scannen, sodass du auch physisch ausgehängt Dokumente schnell digitalisieren kannst.
 Canon LiDE 400 Flachbett-Scanner, A4 Foto- und Dokumentenscan, USB-C 3.0 | A4 Flachbettscanning, 48-Bit Farbtiefe; USB-C-Anschluss, Stromversorgung über USB; kompakt und platzsparendGünstiger als sonst0 %PreisalarmAmazonPreisdaten von amzly.de
 Canon LiDE 300 Flachbettscanner A4 Fotoscanner, USB-Stromversorgung | Flachbett-Scanner für Dokumente und Fotos; scharfe optische Auflösung, USB-betrieben, kompakt und leichtGünstiger als sonst0 %PreisalarmAmazonPreisdaten von amzly.de
 Fujitsu fi-6130 Scanner A4 USB 1.1/2.0 (Zertifiziert und Generalüberholt)159,99 €Amazon
Also worauf wartest du noch?
Installationsanleitung – Schritt für Schritt
version: "3.4"

services:
  broker:
    image: docker.io/library/redis:7.0
    restart: unless-stopped
    volumes:
      - redisdata:/data

  db:
    image: docker.io/library/postgres:16
    restart: unless-stopped
    volumes:
      - ../pgdata:/var/lib/postgresql/data
    environment:
      POSTGRES_DB: paperless
      POSTGRES_USER: paperless
      POSTGRES_PASSWORD: "<deinDBPassword>"

  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:<Versionsnummer>
    restart: unless-stopped
    depends_on:
      - db
      - broker
    ports:
      - "8000:8000"
    healthcheck:
      test: ["CMD", "curl", "-fs", "-S", "--max-time", "2", "http://localhost:8000"]
      interval: 30s
      timeout: 10s
      retries: 5
    volumes:
      - ../data:/usr/src/paperless/data
      - ../media:/usr/src/paperless/media
      - ../export:/usr/src/paperless/export
      - <DeinLaufwerk>:/usr/src/paperless/consume
    environment:
      PAPERLESS_REDIS: "redis://broker:6379"
      PAPERLESS_DBHOST: db
      PAPERLESS_DBENGINE: postgresql
      PAPERLESS_DBNAME: paperless
      PAPERLESS_DBUSER: paperless
      PAPERLESS_DBPASS: "<deinDBPassword>"
      PAPERLESS_SECRET_KEY: "<deinSecretKey>"
      PAPERLESS_URL: "https://paperless.domain.de"

volumes:
  redisdata:
Folgende Parameter müssen dann noch angepasst werden:
- <deinDBPassword> –> generiere ihr für deine Datenbank ein Passwort
- <Versionsnummer> –> trage die letzte Versionsnummer ein – alternativ auch „latest“, um immer die aktuelle Version herunterzuladen
- <DeinLaufwerk> –> trage dein Laufwerk/Ordner ein, um Dokumente automatisch von dort aus einzulesen
- <deinSecretKey> –> generiere einen zufälligen SecretKey
weitere Dateitypen gefällig?
Mit der Gotenberg & Apache Tika-Erweiterung können zusäztlich zum Dokumententyp .pdf noch weitere Dateitypen folgen. Hierzu zählen beispielsweise Office-Dateien wie Word (.doc/.docx), Excel (.xls/.xlsx) oder E-Mails im .eml-Format. Um die Erweiterung zu aktivieren musst du in der YML-Datei nur noch weitere Dinge ergänzen:
services:
  broker:
    image: docker.io/library/redis:7.0
    restart: unless-stopped
    volumes:
      - redisdata:/data

  db:
    image: docker.io/library/postgres:16
    restart: unless-stopped
    volumes:
      - ../pgdata:/var/lib/postgresql/data
    environment:
      POSTGRES_DB: paperless
      POSTGRES_USER: paperless
      POSTGRES_PASSWORD: "<deinDBPassword>"

  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:<Versionsnummer>
    restart: unless-stopped
    depends_on:
      - db
      - broker
      - gotenberg
      - tika
    ports:
      - "8000:8000"
    healthcheck:
      test: ["CMD", "curl", "-fsS", "--max-time", "2", "http://localhost:8000"]
      interval: 30s
      timeout: 10s
      retries: 5
    volumes:
      - ../data:/usr/src/paperless/data
      - ../media:/usr/src/paperless/media
      - ../export:/usr/src/paperless/export
      - "<DeinLaufwerk>:/usr/src/paperless/consume"
    environment:
      PAPERLESS_REDIS: "redis://broker:6379"

      PAPERLESS_DBHOST: db
      PAPERLESS_DBENGINE: postgresql
      PAPERLESS_DBNAME: paperless
      PAPERLESS_DBUSER: paperless
      PAPERLESS_DBPASS: "<deinDBPassword>"

      PAPERLESS_SECRET_KEY: "<deinSecretKey>"
      PAPERLESS_URL: "https://paperless.domain.de"

      # Office-Dokumente und EML-Dateien verarbeiten
      PAPERLESS_TIKA_ENABLED: "1"
      PAPERLESS_TIKA_ENDPOINT: "http://tika:9998"
      PAPERLESS_TIKA_GOTENBERG_ENDPOINT: "http://gotenberg:3000"

  gotenberg:
    image: docker.io/gotenberg/gotenberg:8.37
    restart: unless-stopped
    command:
      - "gotenberg"
      - "--chromium-disable-javascript=true"
      - "--chromium-allow-list=^file:///tmp/.*"

  tika:
    image: docker.io/apache/tika:3.3.1.0
    restart: unless-stopped

volumes:
  redisdata:
Was ist mit euch?
Habt ihr Paperless bereits im Einsatz und wenn ja wie? Würdet ihr wechseln wollen – lasst es uns gerne wissen!



Schreibe einen Kommentar